सीखें
RPS का मनोविज्ञान
 पत्थर
 काग़ज़
 कैंची
संक्षिप्त उत्तर
लोग अक्सर ऐसे क्रम बनाते हैं जो गणितीय रैंडमनेस से अलग होते हैं, पर पत्थर कागज़ कैंची के अध्ययन कोई एक सार्वभौमिक इंसानी पैटर्न स्थापित नहीं करते। 360 छात्रों वाले बार-बार खेलने के एक प्रयोग में आबादी-स्तर का चक्र मिला जिसे नतीजे पर निर्भर प्रतिक्रियाओं से समझाया गया; कंप्यूटर प्रतिद्वंद्वी वाले 31 लोगों के एक अलग प्रयोग में हार और बराबरी के बाद ज़्यादा चाल-बदलाव मिला, जबकि जीत-दोहराने और पत्थर की पसंद सांख्यिकीय रूप से महत्वपूर्ण नहीं थीं। आमने-सामने के एक प्रयोग ने अपनी व्यवस्था में इशारों की नक़ल दर्ज की। ये सीमित आबादी और प्रोटोकॉल वाली उपयोगी परिकल्पनाएं हैं, ऐसे नियम नहीं जो बताएं कि कोई व्यक्ति आगे क्या चलेगा।
इंसानी चुनावों में पैटर्न हो सकते हैं। फिर भी पैटर्न को आपके सामने मौजूद व्यक्ति और परिस्थिति में मापना होगा।
गेम थ्योरी: गणितीय बुनियाद
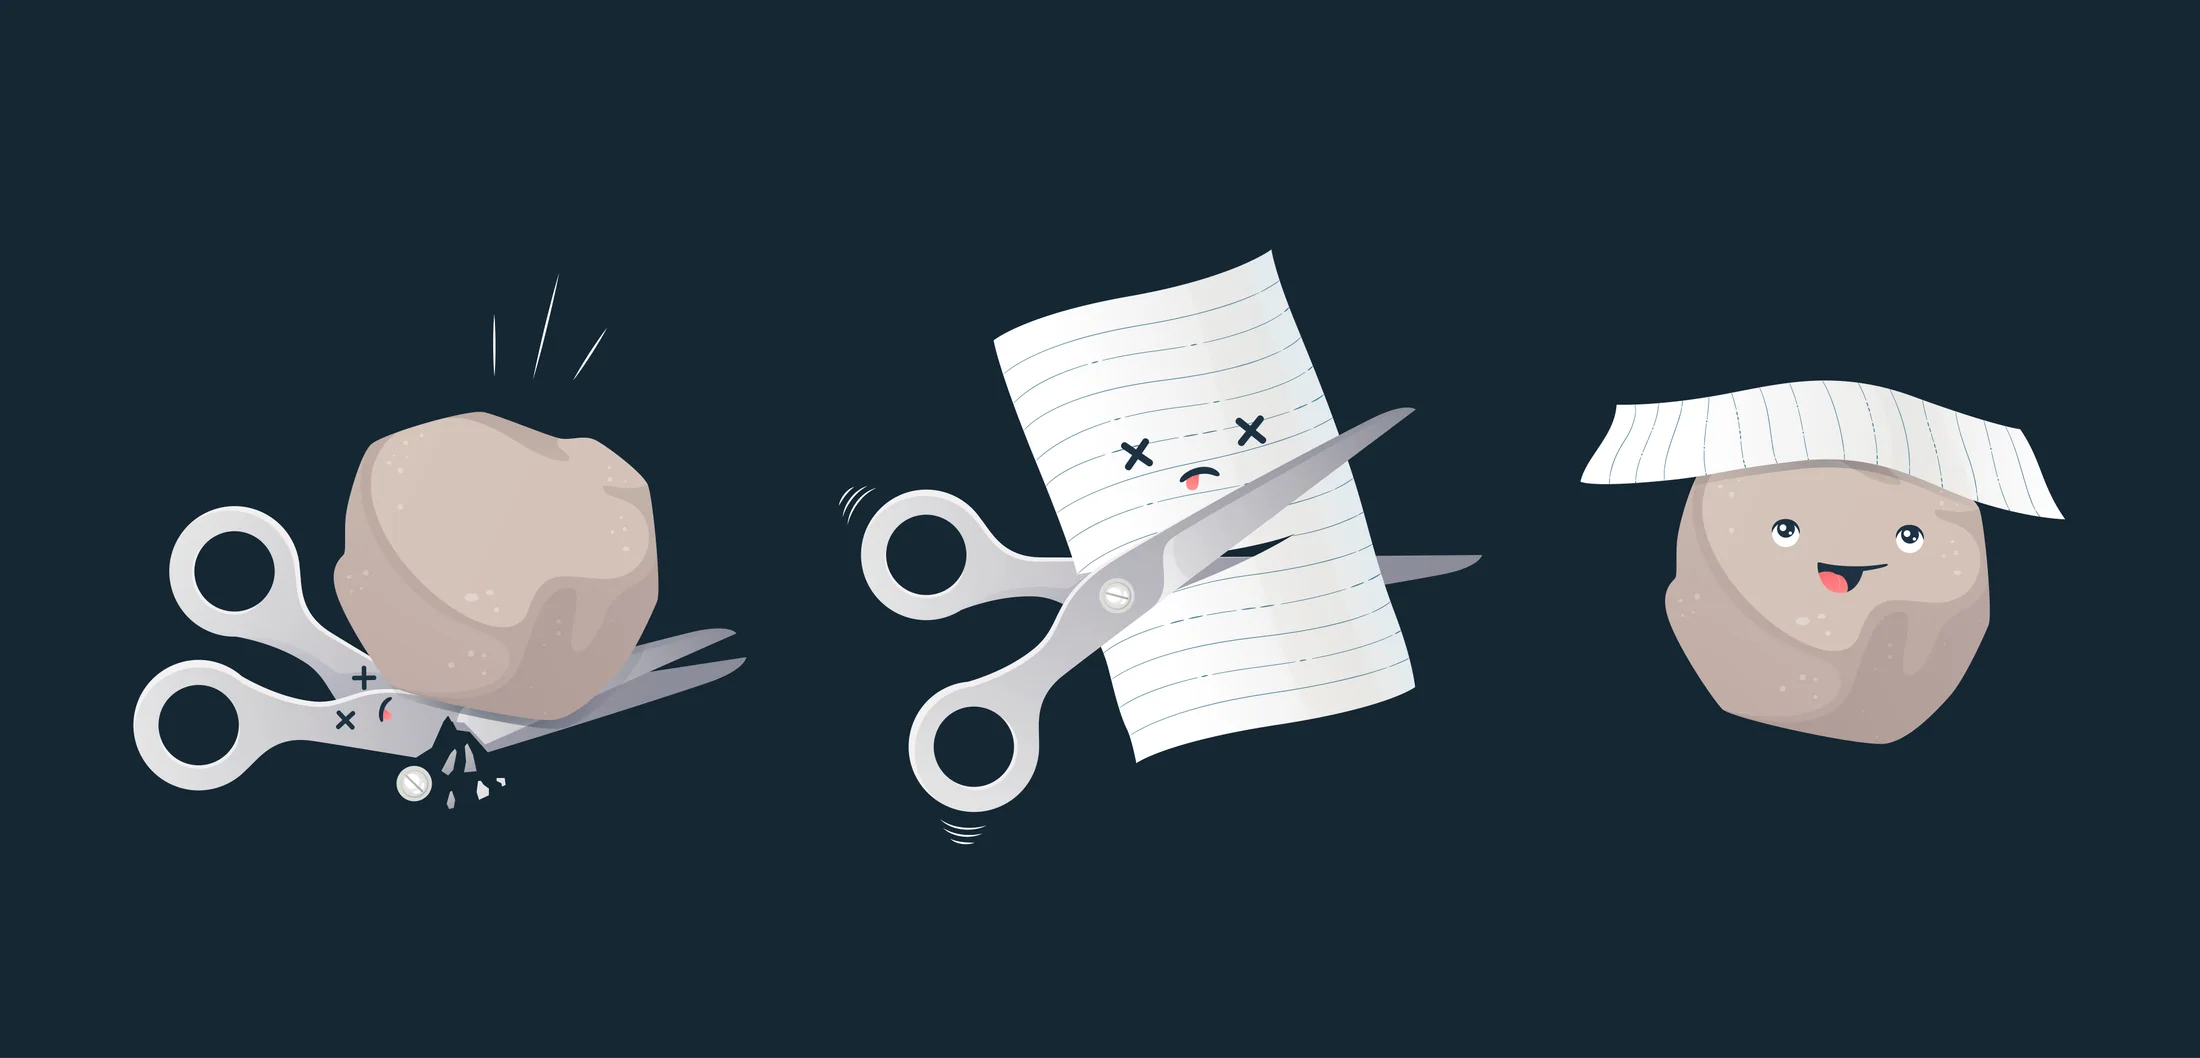
गेम थ्योरी में पत्थर कागज़ कैंची को सीमित, दो-खिलाड़ी, शून्य-योग और एक साथ चाल वाला खेल माना जाता है। जॉन नैश ने साबित किया कि ऐसे खेलों में हमेशा कम से कम एक संतुलन रणनीति होती है। RPS के लिए वह है हर चाल को ठीक ⅓ संभावना से चलना।
इस संतुलन का हर प्रतिद्वंद्वी रणनीति के ख़िलाफ़ अपेक्षित लाभ शून्य है और इसका फ़ायदा नहीं उठाया जा सकता। यह झुकाव वाले प्रतिद्वंद्वी का फ़ायदा भी नहीं उठाता। कोई खिलाड़ी इससे फ़ायदे के साथ तभी हट सकता है जब अनुमानित झुकाव असली हो, काफ़ी देर तक बना रहे, और अनुमान की त्रुटि से ज़्यादा भारी हो।
इंसान रैंडम क्यों नहीं हो सकते
रैंडम-क्रम शोध में बार-बार गणितीय रैंडमनेस से विचलन मिले हैं, जिनमें ज़रूरत से ज़्यादा बारी-बारी बदलाव और लगातार दोहराव से बचना शामिल है। इनका आकार और रूप निर्देशों, समय, प्रतीकों और व्यक्तियों के साथ बदलता है, इसलिए सावधान निष्कर्ष ये हैं:
- दोहराव से बचना - लोग रैंडमनेस की माप से कहीं ज़्यादा बार चाल बदलते हैं, क्योंकि दोहराव "रैंडम नहीं लगता"। असल में वह रैंडम ही होता है। आपका दिमाग़ आपसे झूठ बोल रहा है।
- बारी-बारी बदलने का हद से ज़्यादा इस्तेमाल - प-का-कैं-प-का-कैं रैंडम लगता है, पर यह एकदम अनुमानित चक्र है। आप बस खेल का नाम दोहरा रहे हैं।
- छोटी सीक्वेंस को संतुलित करना - दो पत्थर के बाद लोगों को लगता है कि अब कुछ और चलना चाहिए ताकि "हिसाब बराबर" हो जाए। हर राउंड स्वतंत्र होता है। ब्रह्मांड हिसाब नहीं रखता।
जुआरी का भ्रम यह मान्यता है कि एक स्वतंत्र रैंडम प्रक्रिया को हाल के सिलसिले की भरपाई करनी ही होगी। RPS में प्रतिद्वंद्वी स्वतंत्र न भी हो, इसलिए यह लेबल अपने आप लगाने के बजाय उस मान्यता की जांच करें।
RPS में संज्ञानात्मक पूर्वाग्रह
जीत-पर-टिको, हार-पर-बदलो (WSLS)
नतीजे पर निर्भर व्यवहार बार-बार खेले जाने वाले RPS के लिए एक उपयोगी मॉडल है। Wang et al. के प्रयोग में खिलाड़ियों के वही चाल रखने या आगे घुमाने की संभावनाएं पिछले नतीजे पर निर्भर थीं, और इन व्यक्तिगत सशर्त प्रतिक्रियाओं से आबादी-स्तर के चक्रों को समझाने में मदद मिली।
नतीजा यह नहीं है कि “सब लोग WSLS इस्तेमाल करते हैं।” Wang et al. ने 60 छह-सदस्यीय समूहों में 360 विश्वविद्यालय छात्रों का 300 प्रोत्साहन वाले राउंड तक अध्ययन किया। Dyson et al. ने संतुलित कंप्यूटर के ख़िलाफ़ 225 राउंड में 31 स्नातक छात्रों का अध्ययन किया और हार व बराबरी के बाद चाल-बदलाव पाया; जीत के बाद वही चाल रखना सांख्यिकीय रूप से महत्वपूर्ण नहीं था। आबादी, प्रोत्साहन, फ़ीडबैक, प्रतिद्वंद्वी और मैच की लंबाई, सब सामान्यीकरण को सीमित करते हैं।
प्रमुख शोध
- Wang, Xu & Zhou (2014) — Zhejiang University के 360 छात्रों ने, 60 छह-सदस्यीय समूहों में बंटकर, रैंडम जोड़ियों वाले और पैसों के प्रोत्साहन वाले 300 राउंड पूरे किए। लेखकों ने आबादी-स्तर का चक्र देखा और उसका मॉडल जीत-हार-बराबरी पर निर्भर सशर्त प्रतिक्रियाओं से बनाया।
- Cook et al. (ऑनलाइन प्रकाशित 2011) — देखकर और आंखों पर पट्टी बांधकर आमने-सामने खेले गए RPS की तुलना की और उस प्रयोग-व्यवस्था में स्वचालित नक़ल दर्ज की। यह डिज़ाइन एक ख़ास दृश्य-गतिक असर का समर्थन करता है, सभी लाइव मैचों के लिए किसी सार्वभौमिक अनुमान का नहीं।
- Dyson et al. (2016) — 31 स्नातक छात्रों ने बराबर-रैंडम कंप्यूटर के ख़िलाफ़ 225 राउंड खेले। प्रतिभागियों ने हार और बराबरी के बाद ज़्यादा चाल बदली; जीत के बाद वही चाल रखने और पत्थर को ज़्यादा चुनने के झुकाव सांख्यिकीय रूप से महत्वपूर्ण नहीं थे।
फ़ैसले लेने के बारे में RPS हमें क्या सिखाता है
RPS एक मानक रैंडम रणनीति की तुलना देखे गए क्रमिक चुनावों से करने का संक्षिप्त तरीक़ा देता है। नियंत्रित परिस्थितियों में यह सशर्त निर्भरता, बारी-बारी बदलाव, दोहराव और नक़ल को उजागर कर सकता है। यह किसी व्यक्ति का निदान नहीं कर सकता, व्यक्तित्व का गुण स्थापित नहीं कर सकता, या किसी एक अध्ययन-आबादी के असर को हर संस्कृति या टूर्नामेंट पर लागू नहीं कर सकता।
इससे यह खेल संभाव्यता और प्रयोग-डिज़ाइन सिखाने के लिए उपयोगी बनता है: प्रतिद्वंद्वी, प्रोत्साहन, जानकारी, राउंड की संख्या, नतीजे की परिभाषा और अनिश्चितता बताएं। कोई आकर्षक पैटर्न उपयुक्त तुलना और पर्याप्त अवलोकनों के बाद ही प्रमाण बनता है।
अपने ही झुकाव रियल-टाइम में देखिए
बार-बार अभ्यास करके अपनी चालों और नतीजों के बदलाव दर्ज करें, फिर किसी अनुमान की तुलना बाद के राउंड से करें। छोटा सैंपल ज़्यादा डेटा जुटाने का संकेत है, कोई निदान नहीं।
01 / खेल
- 3चालें
- 3नतीजे
- 9जोड़ियाँ
02 / खेलें