सीखें
रणनीति गाइड
 पत्थर
 काग़ज़
 कैंची
संक्षिप्त उत्तर
ऐसे प्रतिद्वंद्वी के ख़िलाफ़ जो पत्थर, कागज़ और कैंची को स्वतंत्र रूप से बराबर संभावना से चुनता है, किसी तय चाल या पढ़े जा सकने वाले अनुक्रम को बढ़त नहीं है। इंसानी प्रयोगशाला अध्ययनों ने कुछ ख़ास बार-बार खेल वाली परिस्थितियों में सशर्त प्रतिक्रियाएं और अनुक्रम निर्भरता पाई है, पर प्रभाव प्रक्रिया के हिसाब से बदलते हैं और किसी सार्वभौमिक पहली चाल को सही नहीं ठहराते। संतुलित यादृच्छिक खेल से शुरू कीजिए, प्रतिद्वंद्वी-विशेष पर्याप्त साक्ष्य जुटाइए, सिर्फ़ उसी पैटर्न का फ़ायदा उठाइए जो बना रहे, और जब साक्ष्य कमज़ोर हो तो यादृच्छिक आधार-रेखा पर लौट आइए।
जिस आधार-रेखा का फ़ायदा न उठाया जा सके, उससे शुरू कीजिए। उससे तभी हटिए जब बार-बार मिले साक्ष्य अनुमान का समर्थन करें।
बुनियादी बातें
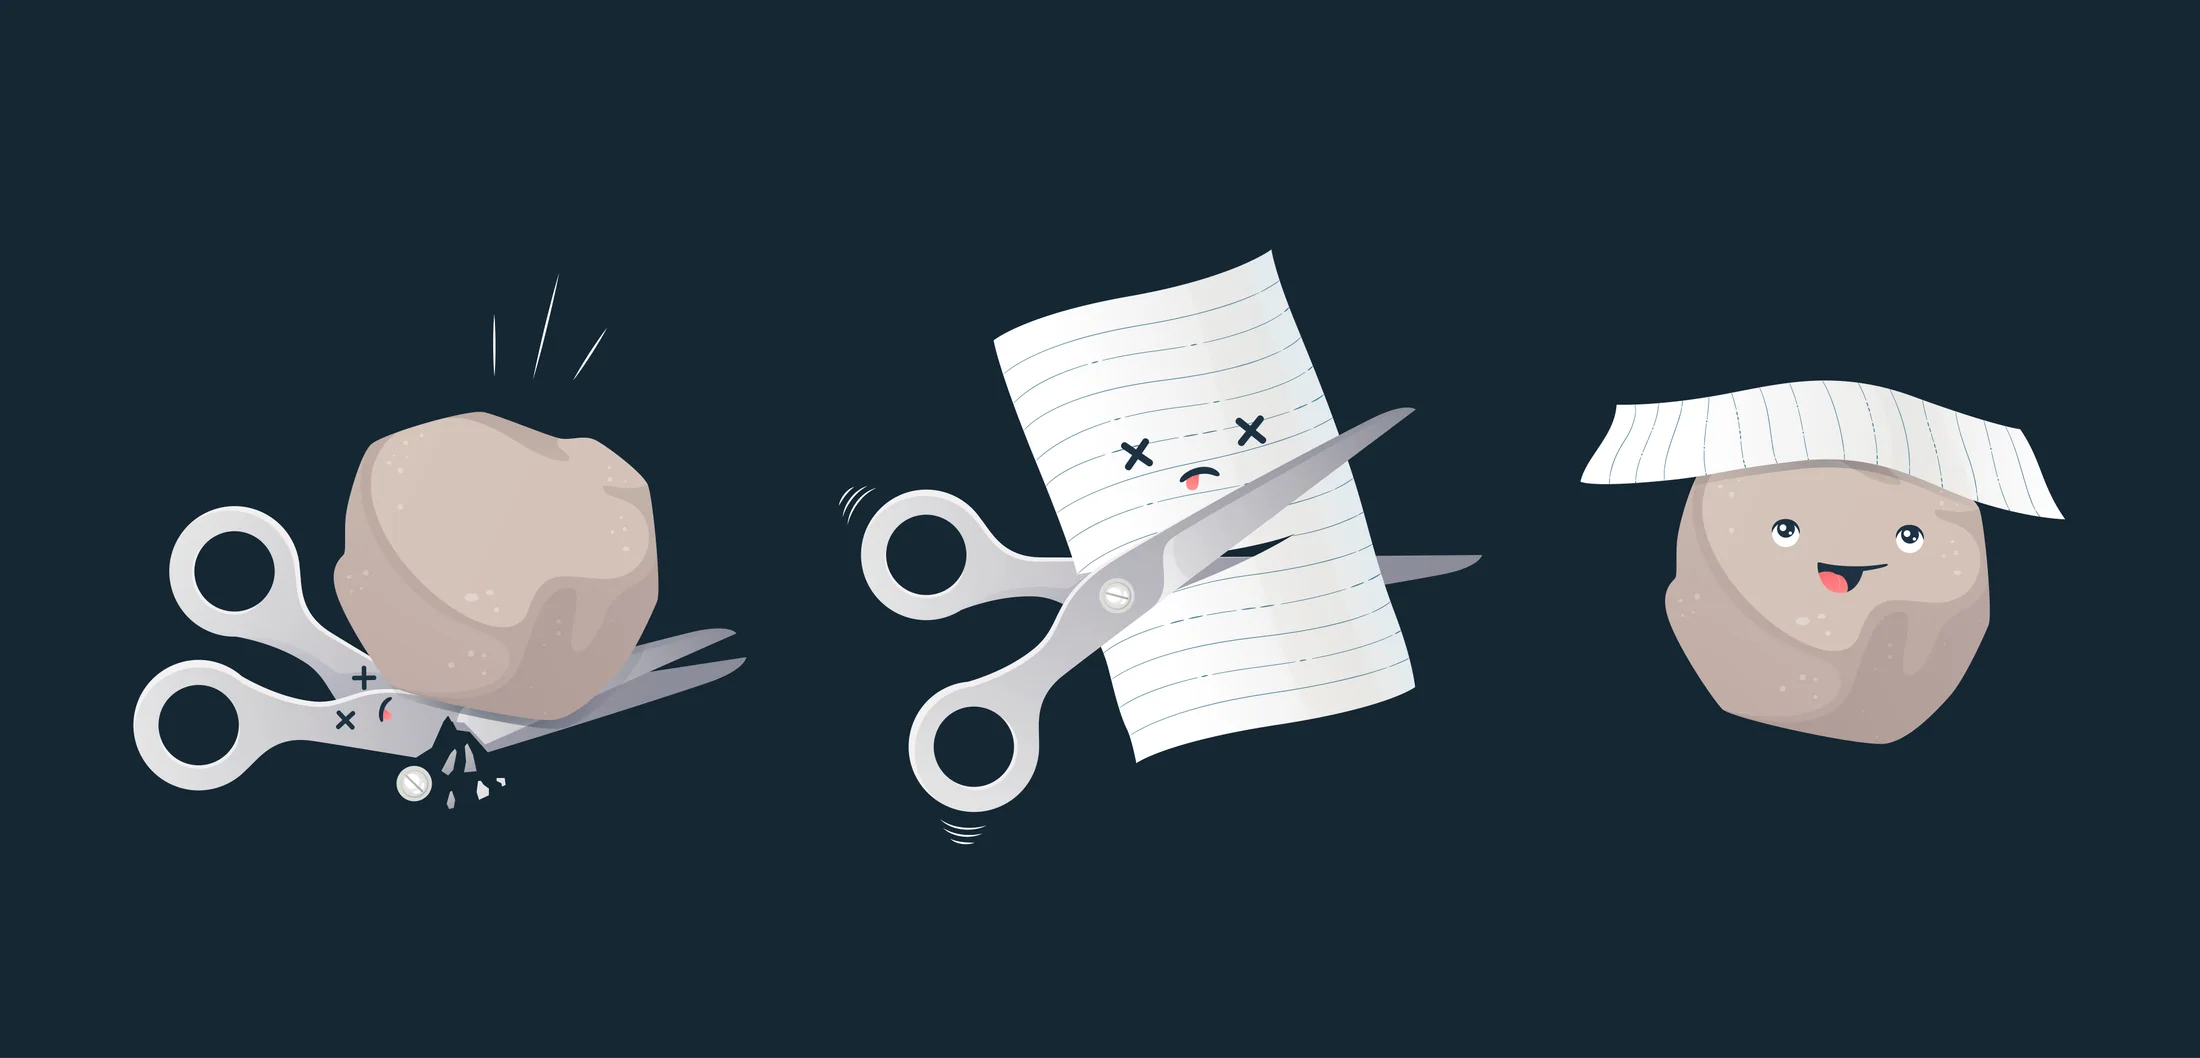
रॉक पेपर सिज़र्स का हर राउंड एक ज़ीरो-सम गेम है: पत्थर कैंची को कुचलता है, कैंची कागज़ को काटती है, कागज़ पत्थर को ढक लेता है। हर चाल ठीक एक को हराती है और एक से हारती है। गेम पूरी तरह संतुलित है। कोई भी चाल स्वाभाविक रूप से ज़्यादा मज़बूत नहीं है।
यह सममिति समान यादृच्छिक चुनाव को एक तर्कसंगत आधार-रेखा बनाती है। बार-बार के इंसानी चुनावों में फिर भी सशर्त पैटर्न हो सकते हैं, पर एक प्रयोगशाला डिज़ाइन में देखा गया पैटर्न हर खिलाड़ी या हर मैच का नियम नहीं है।
नैश संतुलन
मानक शून्य-योग भुगतान मैट्रिक्स के लिए, एकमात्र मिश्रित-रणनीति नैश संतुलन पत्थर, कागज़ और कैंची को स्वतंत्र रूप से 1/3-1/3 संभावना से चुनना है। उस रणनीति के ख़िलाफ़ कोई भी प्रतिद्वंद्वी अपना मिश्रण बदलकर सकारात्मक अपेक्षित मान हासिल नहीं कर सकता।
समान यादृच्छिक चुनाव एक सुरक्षा आधार-रेखा है, यह वादा नहीं कि हर छोटा मैच बराबरी पर ख़त्म होगा या इंसान इसका पालन करते हैं। Wang et al. (2014) और Dyson et al. (2016) ने कुछ ख़ास बार-बार खेल वाले प्रयोगों में सशर्त व्यवहार की सूचना दी। ये निष्कर्ष प्रतिद्वंद्वी-विशेष अनुमान को परखने का समर्थन करते हैं; ये यह मान लेने का समर्थन नहीं करते कि हर विजेता चाल दोहराता है, हर हारने वाला बदलता है, या हर पहली चाल पत्थर की ओर झुकी होती है।
इंसानी झुकावों का फ़ायदा उठाना
बार-बार खेल वाले अध्ययनों ने स्वतंत्र समान यादृच्छिक चुनाव से विचलन मापे हैं, पर उनकी दिशा और आकार प्रतिभागियों, प्रोत्साहनों, प्रतिद्वंद्वी, फ़ीडबैक और राउंड की संख्या पर निर्भर करते हैं:
2. जीतो तो टिको, हारो तो बदलो (WSLS)
2014 के एक प्रयोगशाला प्रयोग में Zhejiang विश्वविद्यालय के 360 छात्रों ने यादृच्छिक जोड़ियों और नक़द प्रोत्साहन के साथ छह-व्यक्ति समूहों में 300 राउंड खेले। शोधकर्ताओं ने नतीजे पर निर्भर वही-चाल-रखने और घुमाने की संभावनाओं का मॉडल बनाया और लगातार बना रहने वाला आबादी-स्तर का चक्र देखा। इसे अक्सर जीतो-तो-टिको, हारो-तो-बदलो के रूप में संक्षेप में कहा जाता है, पर शोधपत्र एक ज़्यादा समृद्ध सशर्त-प्रतिक्रिया प्रणाली की सूचना देता है।
2016 के एक प्रयोग में, जिसमें 31 स्नातक छात्रों ने समान-यादृच्छिक कंप्यूटर के ख़िलाफ़ 225 राउंड खेले, हार और बराबरी के बाद काफ़ी ज़्यादा बदलाव पाया गया। जीत के बाद टिके रहना सिर्फ़ एक संख्यात्मक, सांख्यिकीय रूप से महत्वहीन प्रवृत्ति थी, और पत्थर का ज़्यादा चुनाव भी महत्वहीन था। पिछले नतीजे को परखने लायक़ एक विशेषता मानिए, गारंटीशुदा भविष्यवाणी नहीं।
3. दोहराव-विरोधी झुकाव
जान-बूझकर यादृच्छिक अनुक्रम बनाने वाले लोग अक्सर बहुत ज़्यादा बदलते हैं या लगातार एक जैसी चालों से बचते हैं, पर प्रदर्शन कार्य और निर्देशों के साथ बदलता है। दोहराई गई चाल अपने आप में साक्ष्य नहीं है: स्वतंत्र समान यादृच्छिक चुनाव में लगातार तीन पत्थर की संभावना किसी भी नामित तीन-चाल अनुक्रम जितनी ही है।
शुरुआती ग़लतियाँ जिनसे बचें
| ग़लती | यह क्यों नुक़सान पहुँचाती है | Fix |
|---|---|---|
| हमेशा पत्थर से शुरुआत करना | हर कोई ऐसा करता है। हर कोई जानता है कि हर कोई ऐसा करता है। | कागज़ या कैंची से शुरुआत करें |
| कभी भी एक चाल न दोहराना | प्रतिद्वंद्वी जानता है कि आप क्या नहीं करेंगे | जान-बूझकर दोहराव को होने दें |
| WSLS का धार्मिक भाव से पालन करना | आप एक मशीन बन जाते हैं, और अच्छे वाले तरीक़े से नहीं | जान-बूझकर चक्र को तोड़ें |
| अपनी चाल ज़ोर से बोलना | यह ज़ाहिर-सी बात लगती है, लेकिन लोग करते हैं | चुप रहें। कृपया। |
| गिनती की लय को नज़रअंदाज़ करना | फ़ॉल्स स्टार्ट और देर से फेंकी गई चाल पर आप डिस्क्वालीफ़ाई हो सकते हैं | 1-2-3-दिखाओ की लय का अभ्यास करें |
प्रतिस्पर्धी खेल के लिए उन्नत दांव
प्रतिद्वंद्वी की चलती-फिरती मॉडलिंग
प्रतिद्वंद्वी की चाल और उससे पहले का नतीजा दर्ज कीजिए, फिर संभावित नियमों की तुलना एक संतुलित आधार-रेखा से कीजिए। तीन से पांच राउंड एक परिकल्पना बनाने के लिए काफ़ी हैं, किसी स्थिर प्रवृत्ति को स्थापित करने के लिए नहीं। परीक्षण जारी रखिए और जब बाद की चालें समर्थन न करें तो उस अनुमान को छोड़ दीजिए।
गैम्बिट
पहले से तय किया गया निजी अनुक्रम प्रतिक्रियात्मक चुनावों को कम कर सकता है, पर तीन चालों की तय स्क्रिप्ट दोहराई जाए तो उसका फ़ायदा उठाया जा सकता है। बिना दिखने वाली संरचना के अनुक्रम बनाइए या चुनिए, हर एक को ज़्यादा से ज़्यादा योजना के मुताबिक़ इस्तेमाल कीजिए, और डेटा के बिना यह दावा मत कीजिए कि कोई नामित अनुक्रम किसी वर्ग के खिलाड़ियों का तोड़ है।
AI और एल्गोरिदम वाला खेल
सॉफ़्टवेयर इंसान से ज़्यादा संभावित पैटर्न परख सकता है, पर भविष्यवाणी फिर भी दोहराए जा सकने वाले संकेत और ईमानदार आउट-ऑफ़-सैंपल मूल्यांकन पर निर्भर करती है:
- सशर्त मॉडल: हाल की एक सीमित स्थिति, जैसे पिछली चाल और नतीजे, से अगली चाल का अनुमान लगाइए। ये तभी मदद करते हैं जब वह निर्भरता बनी रहे।
- मशीन लर्निंग: ज़्यादा जटिल प्रवृत्तियों को तभी फ़िट कीजिए जब प्रतिद्वंद्वी-विशेष पर्याप्त उदाहरण हों, फिर उन चालों पर मूल्यांकन कीजिए जिन पर मॉडल को प्रशिक्षित नहीं किया गया। डेटा याद रखना भविष्य के खेल की भविष्यवाणी करने जैसा नहीं है।
इंसान भी एक छोटी गिनती-तालिका के साथ यही अनुशासन अपना सकता है: पैटर्न पर दांव लगाने से पहले उसे परिभाषित कीजिए, सफलताएं और विफलताएं गिनिए, और जब नमूना अनिर्णायक हो तो समान यादृच्छिक चुनाव पर लौट आइए।
परखो-और-रीसेट-करो अभ्यास योजना
इसे सभी प्रतियोगियों के बारे में दावे की बजाय एक खंडनीय अभ्यास दिनचर्या की तरह इस्तेमाल कीजिए:
- संतुलित शुरुआत कीजिए: प्रतिद्वंद्वी की चालें और पिछले नतीजे दर्ज करते हुए स्वतंत्र, लगभग बराबर चुनाव कीजिए।
- एक अनुमान परखिए: जब कोई ख़ास सशर्त प्रवृत्ति बार-बार दिखे, तो सीमित संख्या की चालों के लिए उसका तोड़ चुनिए और दर्ज कीजिए कि क्या वह संयोग से बेहतर भविष्यवाणी करता है।
- जल्दी रीसेट कीजिए: अगर अनुमान कमज़ोर पड़े, तो संतुलित आधार-रेखा पर लौट आइए। जब अवलोकन किसी आकर्षक कहानी का समर्थन करना बंद कर दें, तो उसकी क़ीमत चुकाते मत रहिए।
छोटे मैचों में सैंपलिंग का बहुत शोर होता है। किसी तरीक़े को कई तुलनीय निर्णयों पर परखिए, अभ्यास को आधिकारिक नतीजों से अलग रखिए, और एक सफल अनुमान को कभी कौशल का सबूत मत बताइए।
रॉक पेपर सिज़र्स कैसे जीतें
बार-बार खेल के लिए एक तर्कसंगत क्रम:
- 1/3, 1/3, 1/3 से शुरू कीजिए। अगर आप जानना चाहते हैं कि स्वतंत्र समान खेल कैसा लगता है, तो अभ्यास में असली रैंडमाइज़र इस्तेमाल कीजिए।
- अनुमान को परिभाषित कीजिए। “हार के बाद यह प्रतिद्वंद्वी कैंची चुनता है” परखा जा सकता है; “वे घबराए हुए दिखते हैं” अभी भविष्यवाणी नहीं है।
- लगातार एक जैसी चालें होने दीजिए। स्वतंत्र यादृच्छिक खेल में दोहराव स्वाभाविक रूप से होते हैं, इसलिए ज़बरदस्ती बदलना ठीक वही पैटर्न बना सकता है जिसकी प्रतिद्वंद्वी को ज़रूरत है।
- हर परीक्षण गिनिए। चूकों को भी सफलताओं जितनी सावधानी से दर्ज कीजिए, और किसी पैटर्न को स्थिर मानने से पहले मुट्ठी भर से ज़्यादा राउंड की मांग कीजिए।
- अनिश्चित हों तो रीसेट कीजिए। जब प्रतिद्वंद्वी-विशेष साक्ष्य कमज़ोर हो या बदल गया हो, तो समान यादृच्छिक चुनाव अपेक्षित मान की रक्षा करता है।
पढ़ना बंद करें। चाल फेंकना शुरू करें।
किसी बताई गई भविष्यवाणी की देखी गई चालों से तुलना करने के लिए अभ्यास का इस्तेमाल कीजिए। इंसानी और रेटेड खेल अलग मोड हैं और मौजूदा सत्र की उपलब्धता पर निर्भर हो सकते हैं।
01 / खेल
- 3चालें
- 3नतीजे
- 9जोड़ियाँ
02 / खेलें