戦略ガイド
突かれないベースラインから始めましょう。そこから離れるのは、繰り返し得られた証拠が読みを裏づけるときだけです。
グー、パー、チョキを独立に等しい確率で選ぶ相手に対しては、決まった手や読める並びに優位はありません。人間を対象とした実験室の研究では、特定の反復プレイの状況で条件つきの反応や並びの依存が見つかっていますが、その効果は手順によって異なり、万人に共通する初手を正当化するものではありません。均衡したランダムなプレイから始め、相手ごとの十分な証拠を集め、持続するパターンだけを突き、証拠が弱いときはランダムなベースラインに戻りましょう。
今すぐ1ラウンド:あなた対コンピューター
出す手を選んでください!
知り合いと対戦したいですか?
基本
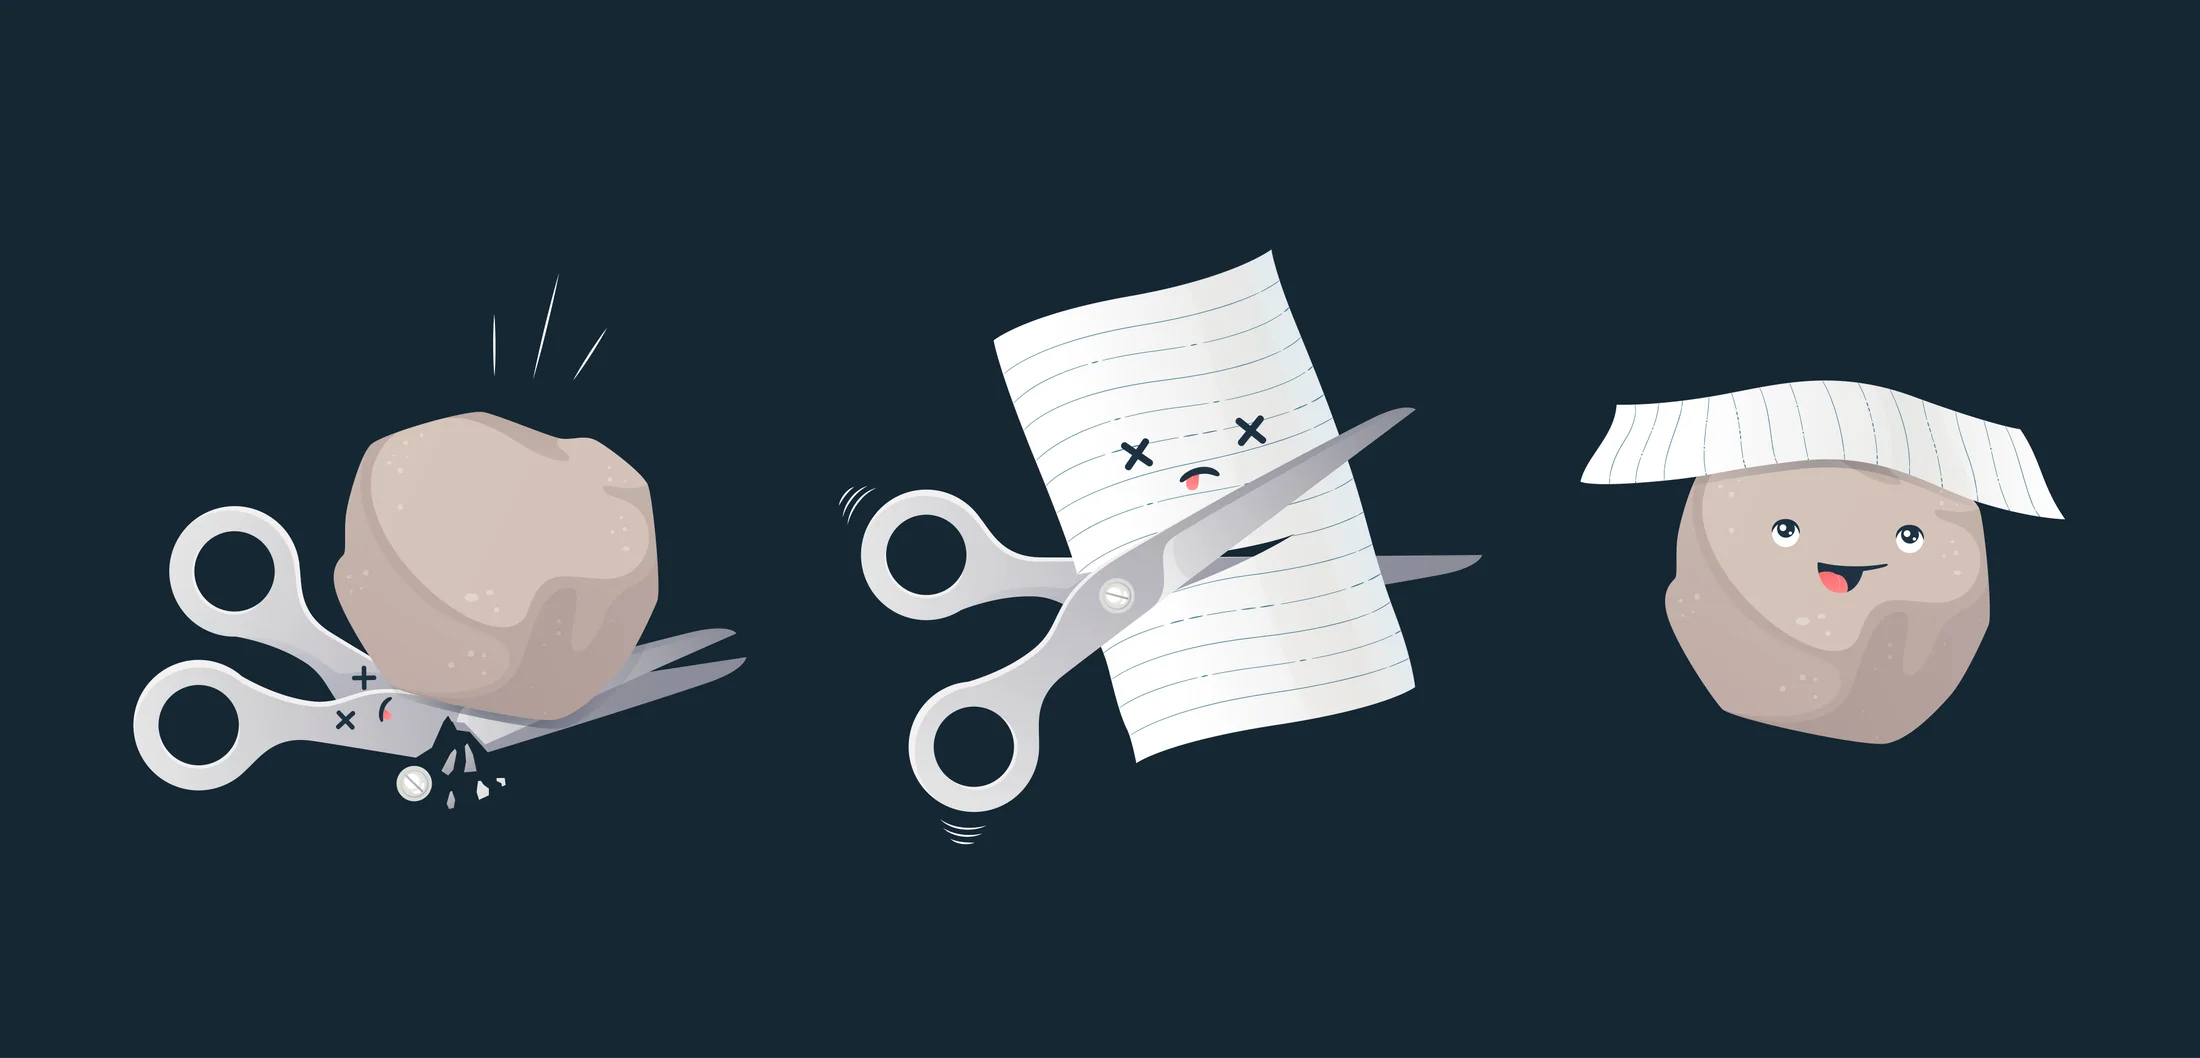
じゃんけんの1ラウンドは、すべてゼロサムゲームです。グーはチョキを砕き、チョキはパーを切り、パーはグーを包む。どの手もちょうど1つに勝ち、1つに負けます。完全に均衡が取れており、本質的に強い手は存在しません。
この対称性があるため、等確率のランダムは正当化できるベースラインになります。人間の繰り返しの選択にも条件つきのパターンが含まれることはありますが、ある実験室の設計で観察されたパターンは、すべてのプレイヤーやすべての試合に当てはまる法則ではありません。
ナッシュ均衡
標準的なゼロサムの利得行列では、唯一の混合戦略ナッシュ均衡は、グー、パー、チョキをそれぞれ独立に1/3ずつの確率で選ぶことです。この戦略に対しては、どの相手も自分の配分を変えることで正の期待値を得ることはできません。
等確率のランダムは安全なベースラインであり、短い試合がすべて引き分けになるとか、人間がそれに従うという約束ではありません。Wangら(2014年)とDysonら(2016年)は、特定の反復プレイの実験で条件つきの行動を報告しました。これらの知見は相手ごとの読みを検証することを後押しするものであり、勝った人は必ず同じ手を続ける、負けた人は必ず変える、初手は必ずグーに偏る、と仮定することを裏づけるものではありません。
人間の偏りを突く
反復プレイの研究は、独立で等確率のランダムからのずれを測定してきましたが、その方向と大きさは、参加者、報酬、相手、フィードバック、ラウンド数によって変わります。
2. 勝ったら同じ手、負けたら変える(WSLS)
2014年の実験室実験では、浙江大学の学生360人が6人組でランダムに組み合わされ、現金の報酬つきで300ラウンドをプレイしました。研究者は結果に条件づけられた「同じ手を続ける」確率と「循環して切り替える」確率をモデル化し、集団レベルで持続する循環を観察しました。これはしばしば「勝ったら同じ手、負けたら変える」と要約されますが、論文が報告しているのはより豊かな条件つき反応の体系です。
学部生31人が等確率ランダムのコンピュータと225ラウンドをプレイした2016年の実験では、負けやあいこのあとに手を切り替えることが有意に多く見られました。勝ったあとに同じ手を続けるのは数値上の傾向にとどまり有意ではなく、グーの選びすぎも有意ではありませんでした。直前の結果は検証すべき特徴のひとつとして使い、確実な予測とはみなさないでください。
3. 繰り返しを避ける偏り
意図的にランダムな並びを作ろうとする人は、切り替えすぎたり連続を避けたりしがちですが、その結果は課題や指示によって変わります。同じ手の繰り返しはそれだけでは証拠になりません。独立で等確率のランダムのもとでは、グーが3回続く確率は、名前のついたどの3手の並びとも同じです。
初心者が避けたい間違い
| よくある間違い | なぜ損なのか | Fix |
|---|---|---|
| いつもグーから入る | みんなそうします。そして、みんながそうすることをみんな知っています。 | パーかチョキから入る |
| 同じ手を絶対に繰り返さない | 相手に「出さない手」が読まれます | 意図的に同じ手を続ける |
| WSLSを馬鹿正直に守る | 機械のようになります。しかも、かっこいいほうの機械ではなく | 意図的に循環を断ち切る |
| 出す手を口に出す | 当たり前に見えますが、実際にやる人がいます | 黙りましょう。お願いします。 |
| かけ声のリズムを無視する | フライングや出し遅れで失格になります | 1-2-3-ぽんのリズムを練習する |
競技レベルの応用戦術
相手のモデル化
相手の手と直前の結果を記録し、候補となるルールを均衡したベースラインと比べましょう。3〜5ラウンドあれば仮説は立てられますが、安定した傾向を確かめるには足りません。検証を続け、その後の手が裏づけなければ読みは捨ててください。
ギャンビット
あらかじめ決めて人に明かさない並びは反射的な選択を減らせますが、決まった3手の台本は繰り返し使えば突かれます。目に見える構造のない並びを生成または選び、それぞれ計画した範囲でのみ使い、データなしに特定の名前つきの並びがある種のプレイヤーに有効だと主張しないでください。
AIとアルゴリズムのプレイ
ソフトウェアは人間が追いきれないほど多くのパターン候補を検証できますが、予測は依然として、再現性のあるシグナルと、学習に使っていないデータでの誠実な評価にかかっています。
- 条件つきモデル:直前の手と結果など、限られた直近の状態から次の手を推定します。役に立つのは、その依存関係が続く場合だけです。
- 機械学習:相手ごとの十分な事例がそろってから、より豊かな傾向を当てはめ、モデルが学習に使っていない手で評価します。データを覚えることは、今後のプレイを予測することと同じではありません。
人間も、簡単な集計で同じ規律を使えます。賭ける前にパターンを定義し、当たりと外れを数え、サンプルで結論が出ないときは等確率のランダムに戻りましょう。
検証とリセットの練習プラン
すべての競技者についての主張ではなく、反証可能な練習の手順として使ってください。
- 均衡した状態から始める:相手の手と直前の結果を記録しながら、独立でおおむね等しい選択をします。
- 読みを1つ検証する:特定の条件つきの傾向が繰り返し現れたら、限られた回数だけそのカウンターを選び、偶然より良く予測できるかを記録します。
- すばやくリセットする:読みが弱まったら、均衡したベースラインに戻りましょう。観察が裏づけなくなったあとも、魅力的な筋書きに代償を払い続けないでください。
短い試合には大きな標本のばらつきが含まれます。方法は多数の比較可能な判断で評価し、練習と公式の結果を分け、一度うまく当たったことを実力の証拠とは決して言わないでください。
じゃんけんに勝つ方法
反復プレイのための、正当化できる手順:
- 1/3、1/3、1/3から始める。独立で等確率のプレイがどんな感覚かを知りたければ、練習では実際の乱数生成器を使いましょう。
- 読みを定義する。「この相手は負けたあとチョキを選ぶ」は検証できます。「緊張しているように見える」は、まだ予測ではありません。
- 連続を許す。独立なランダムのプレイには自然に繰り返しが含まれるので、無理に切り替えると、まさに相手が必要とするパターンを作ってしまいかねません。
- すべての検証を数える。当たりと同じくらい丁寧に外れも記録し、パターンを安定したものとみなす前に、数ラウンドより多くのデータを求めましょう。
- 不確かなときはリセットする。相手ごとの証拠が弱いか変化したときは、等確率のランダムが期待値を守ります。
読むのはここまで。あとは出すだけ。
練習を使って、事前に述べた予測と観察された手を比べましょう。人間同士の対戦とレート戦は別のモードであり、その時点のセッションの空き状況に左右されることがあります。